 Ai Everything
 LEAP26
 ASUS
 ACER
 RØDE
 REDMAGIC
 قوائم أراجيك
 TV
 Partner With Us
جوجل تكشف النقاب عن إصدار Gemini 4 Argon وتفتح آفاقاً جديدة للذكاء الاصطناعي

أعلنت جوجل عن نموذج Argon الجديد لتعزيز قدرة الروبوتات على فهم العالم الفيزيائي.
تمكن النموذج من تحويل الفيديوهات العادية إلى محاكاة لتدريب الروبوتات بشكل فعال.
تسعى جوجل لتسريع تطوير الروبوتات وتقليل الحاجة للنمذجة اليدوية المكلفة.
يتيح النظام الجديد فرصًا للفرق الصغيرة لبناء تطبيقات عملية بسهولة أكبر.
رغم التقنيات المتقدمة، التحديات العملية لا تزال قائمة في البيئات الفعلية.
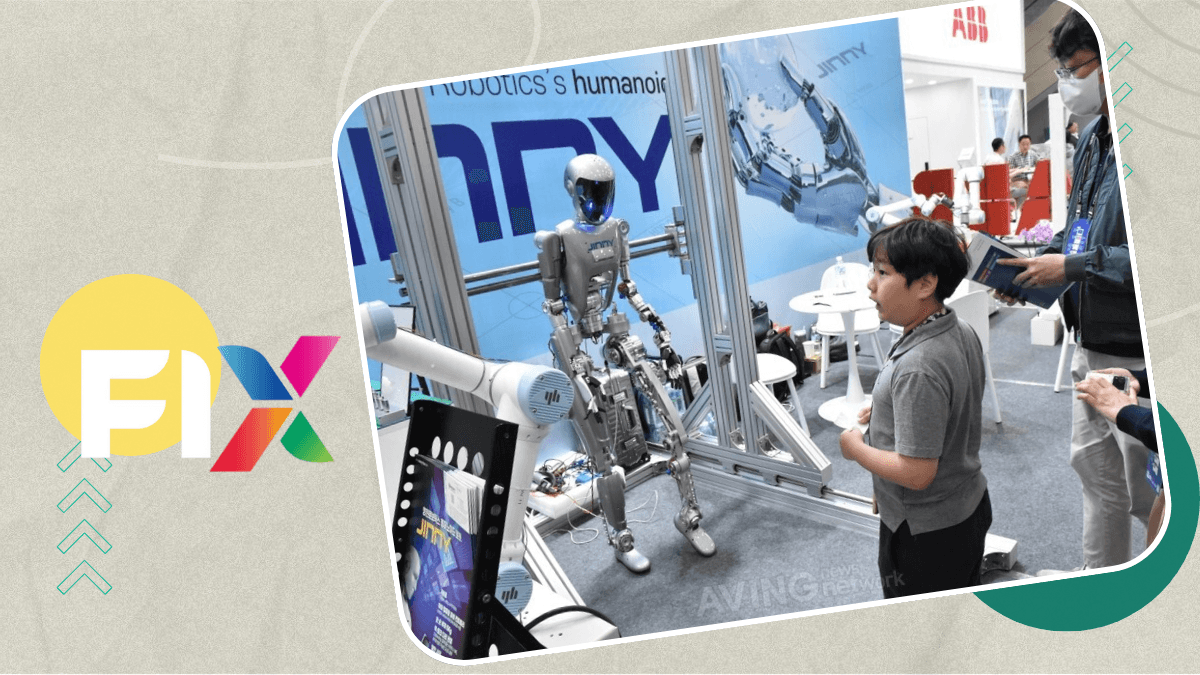
من السهل أن يبدو مشهد روبوت ينجح في رمية متتالية مجرد لقطة استعراضية أخرى. لكن ما يلفت الانتباه هنا ليس الرمية نفسها، بل الطريق التي أوصلت إليها. جوجل أعلنت إتاحة Gemini 4 Argon، أحدث نماذجها المتقدمة، مع تركيز واضح على قدرته في فهم العالم الفيزيائي وتحويل الفيديوهات العادية إلى محاكاة قابلة لتدريب الروبوتات. الخبر في ظاهره عن نموذج ذكاء اصطناعي جديد، لكنه في العمق يشير إلى محاولة جدية لتقليص واحدة من أبطأ مراحل تطوير الروبوتات وأكثرها كلفة.
ما الذي قدمته جوجل فعلياً
بحسب ما نشرته Google DeepMind ومدونة المطورين في جوجل، فإن Argon صُمم كنموذج عام للاستدلال الفيزيائي، أي أنه لا يكتفي بتحليل النصوص أو الصور، بل يحاول فهم الحركة والعلاقات المكانية والسببية داخل بيئات ثلاثية الأبعاد. هذه النقطة مهمة لأن الروبوتات لا تعمل في فراغ رقمي منظم، بل في عالم مليء بالاحتكاك والزوايا والأجسام غير المتوقعة.
جوجل تطرح النموذج للاستخدام عبر Gemini API المدفوع وللمشتركين في Google AI، مع تسويق رئيسي موجه إلى البرمجة والعمل المؤسسي والأمن السيبراني. لكن أكثر ما يميزه في هذه الجولة هو حضوره داخل الروبوتات، تحديداً في بناء بيئات المحاكاة التي يعتمد عليها التدريب قبل الانتقال إلى العالم الحقيقي.
من الفيديو إلى المحاكاة ثم إلى الواقع
أبرز ما استعرضته جوجل هو خط العمل الذي تسميه Video to Sim to Real. الفكرة بسيطة ظاهرياً ومعقدة جداً تقنياً. يشاهد النموذج فيديو بشرياً عادياً، يستنتج منه شكل البيئة والحركة المطلوبة، يبني محاكاة فيزيائية، ثم يولد الشيفرة اللازمة كي يتدرب الروبوت داخلها قبل تنفيذ المهمة فعلياً.
في تجربة داخلية، شاهد Argon فيديو لشخص يلعب cornhole، ثم استنتج وضعية المكان وحركات الجسد المطلوبة للرمي، وبعد ذلك كتب كود المحاكاة بنفسه. النتيجة التي عرضتها جوجل أن المهارة انتقلت إلى روبوت Apollo من Apptronik، وتمكن لاحقاً من إصابة الهدف سبع مرات متتالية في اختبار واقعي. حتى لو بدت القصة دعائية في جزء منها، فهي تكشف الاتجاه الأهم هنا: تقليل الاعتماد على النمذجة اليدوية التي كانت تستنزف وقت فرق الروبوتات لأسابيع.
الفارق الحقيقي ليس أن الروبوت رمى بدقة، بل أن بيئة التدريب وُلدت من فيديو عادي بدل أن تُبنى يدوياً من الصفر.
لماذا هذا مهم لصناعة الروبوتات
عنق الزجاجة في الروبوتات لم يكن دائماً في الذراع أو المستشعر أو حتى نموذج التحكم، بل في إعداد البيانات والمحاكاة. تدريب روبوت على مهمة بسيطة ظاهرياً قد يتطلب توصيفاً دقيقاً للأجسام، وخصائص المواد، ونقاط التلامس، وسيناريوهات الفشل. هذه أعمال بطيئة ومكلفة، وغالباً ما تحد من سرعة التجريب أكثر من حدود العتاد نفسه.
إذا نجح نموذج مثل Argon في اختصار هذه المرحلة من أسابيع إلى ساعات، كما تقول جوجل، فهذا لا يعني فقط تسريع التطوير داخل المختبرات الكبيرة، بل قد يفتح الباب أمام فرق أصغر لبناء تطبيقات عملية في المناولة والفرز والخدمات اللوجستية وحتى الأتمتة المنزلية. هنا يتحول الذكاء الاصطناعي من أداة لإنشاء المحتوى أو كتابة الشيفرة إلى طبقة تشغيل تساعد الآلات على اكتساب مهارات جديدة بوتيرة أعلى.
- تسريع بناء المحاكاة يعني دورات اختبار أقصر.
- الانتقال من صورة أو فيديو إلى سيناريو تدريب يقلل العمل اليدوي المتخصص.
- تحسين التدريب الافتراضي قد يخفف كلفة الأخطاء في التجارب الواقعية.
العروض مثيرة لكن القيود قائمة
من السهل الانبهار بعرض روبوت Spot وهو يفتح سلة مهملات بقدمه ثم يتحقق من موضع العلبة عبر كاميرا المعصم قبل إسقاطها في المكان الصحيح. كذلك تبدو نتيجة إنشاء 4500 حلقة تدريبية انطلاقاً من صورة واحدة لطاولة، مع رفع معدل النجاح الفعلي من 56 إلى 75 بالمئة، كأنها قفزة مهمة في التعلم المجسد. لكن كل هذه النتائج لا تزال صادرة من جوجل نفسها، لا من اختبارات مستقلة واسعة.
هذه الملاحظة ليست تفصيلاً صغيراً. فالنماذج التأسيسية قد تقدم أداء لافتاً في العروض المنظمة، لكن مشكلتها تظهر عند الانتقال إلى بيئات أقل نظافة وأكثر فوضى. وجوجل نفسها تشير في البطاقة التعريفية إلى أن Argon قد يهلوس مثل غيره من النماذج. وفي سياق الروبوتات، الهلوسة ليست إجابة خاطئة فقط، بل قد تصبح حركة خاطئة أو تقديراً غير دقيق للمسافة أو القوة أو التوازن.
استدلال فيزيائي أم طبقة عامة جديدة
تقول جوجل إن النموذج حقق 87 بالمئة على معيار ERQA الخاص بالاستدلال المجسد، متقدماً على نماذج حدودية أخرى اختبرتها الشركة، ومن دون ضبط مخصص للروبوتات. إن صح هذا الأداء خارج المختبر، فنحن لا نتحدث فقط عن نموذج قوي في المحاكاة، بل عن طبقة معرفية عامة قد تربط بين الرؤية الحاسوبية والتخطيط والتحكم والبرمجة داخل سير عمل واحد.
هذا ينسجم مع مسار أوسع في الصناعة. الشركات الكبرى لم تعد تتعامل مع الذكاء الاصطناعي بوصفه نظام محادثة فقط، بل كبنية تشغيل قادرة على فهم الكود والصورة والحركة والمعرفة المؤسسية ضمن إطار موحد. دخول هذا المنطق إلى الروبوتات يفسر لماذا تتحدث جوجل عن كامل دورة حياة الروبوت، لا عن مهمة ضيقة أو نموذج متخصص واحد.
بين الطموح والواقع التجاري
إتاحة Argon عالمياً عبر واجهة برمجة مدفوعة تعطيه بعداً تجارياً مباشراً، مع تسعير تمهيدي منخفض نسبياً قبل ارتفاعه لاحقاً. هذا يعني أن جوجل لا تقدم ورقة بحثية فحسب، بل تختبر أيضاً سوقاً ناشئة لخدمات الذكاء الاصطناعي الموجهة إلى المحاكاة والروبوتات والأنظمة الفيزيائية. ومن الواضح أنها تريد أن تتموضع مبكراً قبل أن يصبح هذا النوع من الأدوات مطلباً أساسياً لدى الشركات الصناعية والمختبرات الناشئة.


لكن النجاح التجاري هنا لن يُحسم بعدد المشاهدات أو براعة العروض، بل بقدرة النموذج على الصمود في المهام المتكررة، ومع أجسام مختلفة، وفي بيئات غير مثالية. الروبوتات لا تكافئ الوعود الكبيرة، بل تكافئ الأنظمة التي تعمل كل يوم بالدرجة نفسها من الاعتمادية.
ما تكشفه خطوة جوجل ليس أن الروبوتات أصبحت جاهزة لتعيش بيننا غداً، بل أن معركة تطويرها انتقلت إلى مرحلة جديدة: مرحلة يصبح فيها بناء الفهم الفيزيائي والمحاكاة جزءاً من عمل النموذج نفسه، لا عبئاً منفصلاً على الفريق الهندسي. وإذا ثبتت هذه الفرضية خارج عروض الشركات، فقد يكون الأثر الأعمق ليس في شكل الروبوت، بل في السرعة التي يتعلم بها كيف يتعامل مع العالم.
عبَّر عن رأيك
إحرص أن يكون تعليقك موضوعيّاً ومفيداً، حافظ على سُمعتكَ الرقميَّةواحترم الكاتب والأعضاء والقُرّاء.