OpenAI تشدد حماية تفكير GPT-6.2 Astra وSol ضد التقطير العدائي
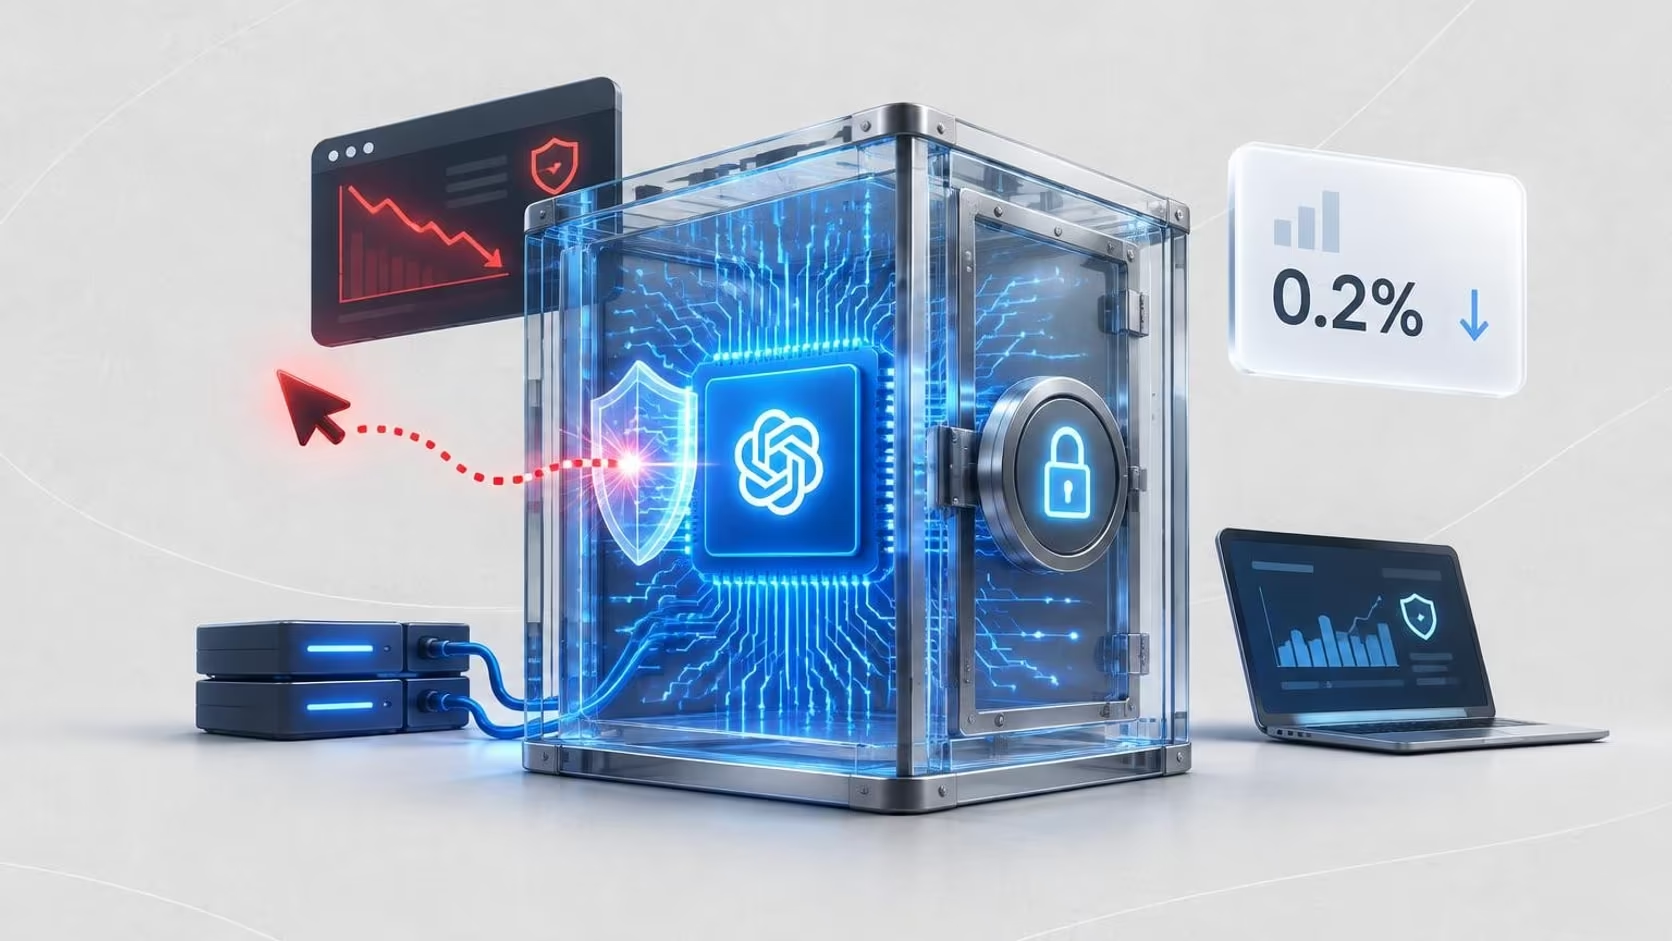

OpenAI شددت حماية التفكير الداخلي لنموذجي GPT-6.
2 Astra وGPT-6.
2 Sol.
نجاح هجمات الاستخراج تراجع من 54.
0% إلى 0.
2% في اختبار داخلي.
التقطير العدائي يتيح نسخ قدرات نموذج دون ضوابط الأمان الخاصة به.
الدفاعات تشمل التدريب والفلاتر وقيود API وملاحقة الحملات المنظمة.
Anthropic تخوض المعركة نفسها وتحظر عشرات الآلاف من الحسابات.
حين تسأل نموذج ذكاء اصطناعي سؤالاً صعباً، يمر بسلسلة من الخطوات الداخلية قبل أن يكتب لك الإجابة. هذه الخطوات صارت اليوم كنزاً يحاول البعض سرقته، وOpenAI أعلنت أنها أغلقت أمامهم معظم الطرق، في معركة تكشف كيف تحولت طريقة تفكير النماذج نفسها إلى سر تجاري وأمني في آن واحد.
من 54% إلى 0.2%: ماذا تغير في GPT-6.2؟
بحسب ما نشرته OpenAI ونقله موقع The Decoder، شددت الشركة حماية التفكير الداخلي لنموذجي GPT-6.2 Astra وGPT-6.2 Sol. وفي اختبار داخلي يعتمد على هجمات آلية قوية، تراجع متوسط نجاح محاولات استعادة التفكير المحمي من طلب سابق من 54.0% على GPT-6 Astra بضماناته الأصلية إلى 0.2% على GPT-6.2 Astra. أما الهجمات على الطلبات الجارية فانخفض نجاحها من 22.9% إلى 0.9%، بحسب الشركة التي تعمل أيضاً على نقل بعض هذه التحسينات إلى GPT-6 Astra.
ما هو التقطير ولماذا يصبح عدائياً؟
التقطير تقنية شائعة في تعلم الآلة، يتعلم فيها نموذج من بيانات ينتجها نموذج آخر، كإجاباته أو طريقة تفكيره أو أحكامه على الإجابات الأفضل. ويسمى النموذج الذي ينتج البيانات المعلم، والذي يتعلم منها الطالب. يصبح الأمر عدائياً حين تستخدم جهة ما مخرجات نموذج متقدم دون إذن لتدريب نموذج آخر بقدرات مشابهة، ثم تشغله دون حماية مماثلة.
الخطر الحقيقي يتجاوز الملكية الفكرية
تقول OpenAI إن المشكلة لا تقتصر على حقوق الملكية، فالنموذج الطالب قد يتعلم قدرات متقدمة دون أن يرث الضوابط التي تحكم استخدامها. ويتضح القلق في المجالات مزدوجة الاستخدام مثل الأمن السيبراني والأحياء، فالنموذج الذي يساعد المدافعين على اكتشاف الثغرات قد يساعد مهاجماً على استغلالها.
وفي دراسة داخلية، وجدت الشركة أن الطالب المدرب على خطوات التفكير الدقيقة تفوق عموماً على الطالب المدرب على ملخصات التفكير بعد الضبط الدقيق، وهو ما تراه دليلاً على أن حماية هذه الخطوات تحد من انتقال القدرات السيبرانية.
دفاع على مستويين
على مستوى الطلب الواحد، تجمع OpenAI بين تدريب النموذج على رفض محاولات استخراج تفكيره، وفلاتر تفحص المدخلات وأخرى ترصد أي تسريب في الرسائل وفي معطيات استدعاء الأدوات، إلى جانب قيود في واجهة API. ومع GPT-6.2 ربطت الشركة التفكير المحمي بسجل المحادثة الذي أنتجه، ومنعت عائلات النماذج الأقدم ذات الضمانات الأضعف من قراءته.
- تدريب عدائي يعلم النموذج رفض كشف تفكيره المحمي.
- فلاتر للمدخلات والمخرجات تشمل استدعاءات الأدوات.
- قيود API تمنع نقل التفكير بين المحادثات والنماذج.
أما على مستوى الحملات المنظمة، فتبحث الشركة عن أنماط في إشارات الطلبات والحسابات، وبحسب The Decoder تحظر ما بين آلاف وعشرات الآلاف من الحسابات أسبوعياً.
Anthropic في الخندق نفسه
لا تخوض OpenAI هذه المعركة وحدها، إذ يذكر The Decoder أن Anthropic تحارب بدورها هجمات التقطير المنظمة وتحظر عشرات الآلاف من الحسابات، مع نجاح يقدر بين 90 و99% من الحالات بحسب التقارير، كما دعت إلى استجابة منسقة من الصناعة وصناع السياسات.
ربما يبدو تفكير النموذج تفصيلاً تقنياً بعيداً عن المستخدم العادي، لكنه في الحقيقة الطبقة التي تقرر من يملك القدرة ومن يملك الضوابط، والسؤال الذي يبقى مفتوحاً هو إلى أي حد يمكن حماية المعرفة حين تكون الإجابة نفسها مصدراً للتعلم.
عبَّر عن رأيك
إحرص أن يكون تعليقك موضوعيّاً ومفيداً، حافظ على سُمعتكَ الرقميَّةواحترم الكاتب والأعضاء والقُرّاء.