GITEX
 Ai Everything
 LEAP26
 ASUS
 ACER
 RØDE
 REDMAGIC
 قوائم أراجيك
 TV
 Partner With Us
Fable 5.2 من Anthropic ينجز 41% من مشاريع العمل الحر الحقيقية بجودة احترافية

أنجز Fable 5.
2 نسبة 41.
3% من مشاريع عمل حر حقيقية بجودة احترافية.
أفضل نظام قبل نحو عام أنجز 2.
5% فقط من المهام.
حلّ Opus 5.
5 ثانياً بنسبة 21.
25% وGPT 6 Astra ثالثاً بنسبة 20.
83%.
يضم الاختبار 240 مشروعاً من منصة Upwork قيمتها نحو 144 ألف دولار.
ما زال النموذج يتعثر في التصميم الصناعي للمنتجات والرسوم المتحركة.
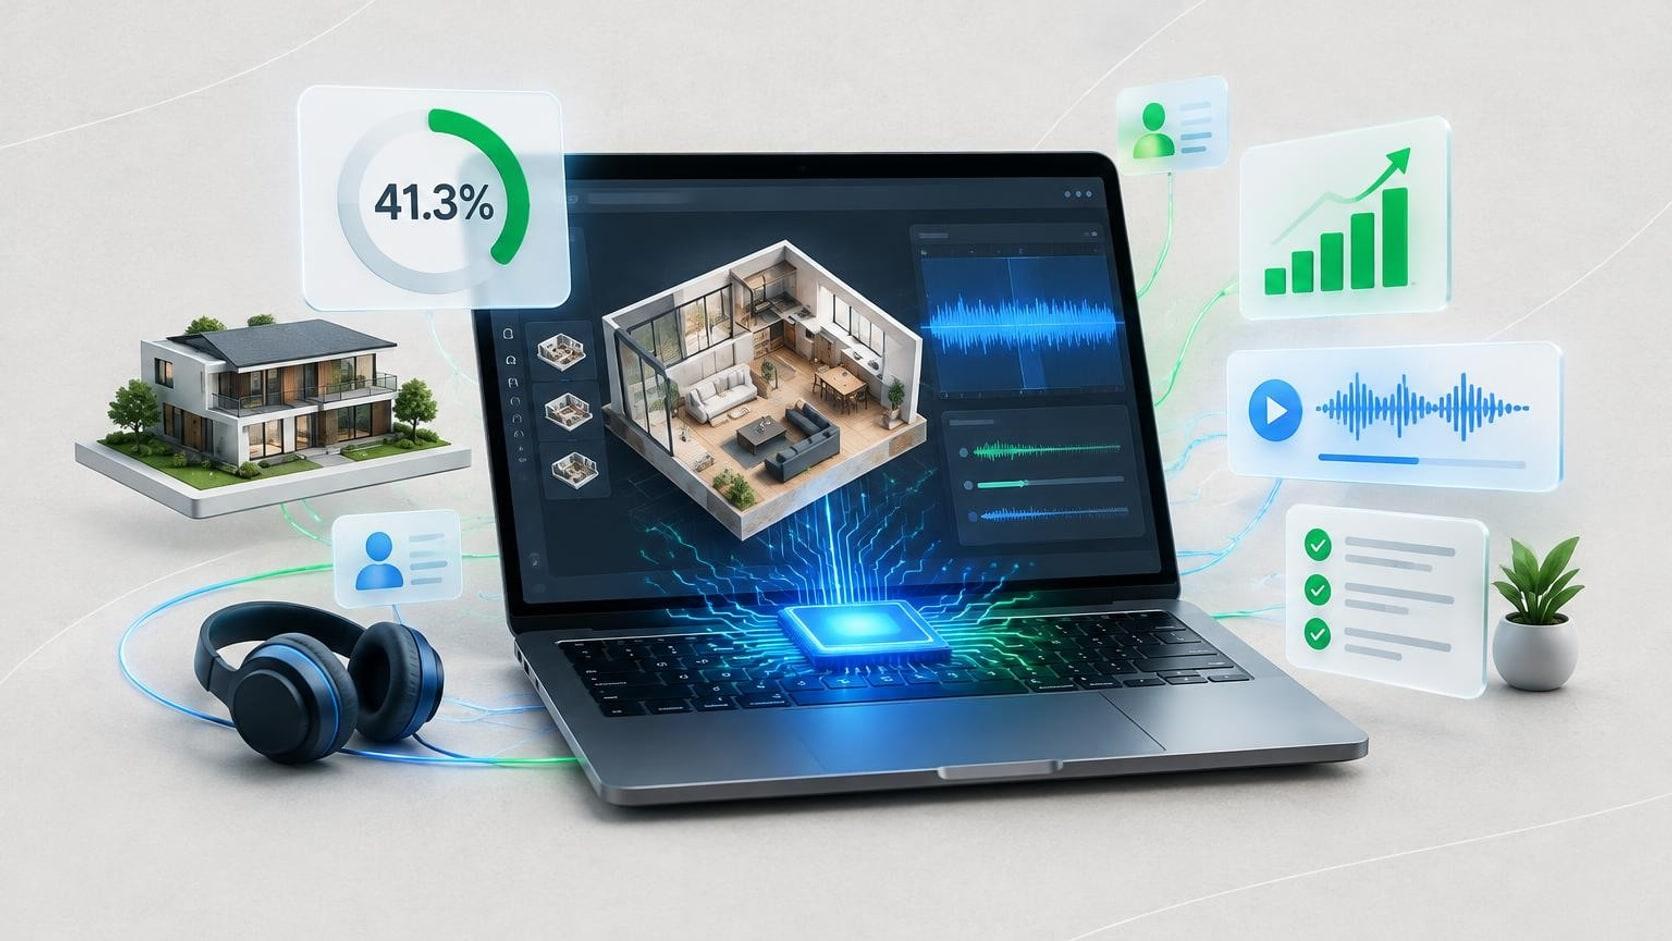
تخيّل مصمماً مستقلاً يفتح بريده صباحاً ليجد مشروعاً لتصميم حمّام بثلاثة أبعاد، وهو يعرف أن إنجازه سيأخذ منه يوماً أو يومين من العمل. الآن هناك منافس جديد على المهمة نفسها لا ينام ولا يتعب. فبحسب تقرير The Decoder، أنجز نموذج Fable 5.2 من Anthropic أكثر من 41% من مشاريع عمل حر حقيقية بجودة يقبلها عميل يدفع المال، وهو رقم يعيد طرح السؤال عن مستقبل العمل الحر.
قفزة من 2.5% إلى 41.3% خلال عام
تصدّر Fable 5.2 مؤشر Remote Labor Index الذي طورته Scale Labs ومركز سلامة الذكاء الاصطناعي CAIS بنسبة 41.3%. وعند إطلاق المؤشر قبل نحو عام، لم يتجاوز أفضل نظام حينها، وهو Manus، نسبة 2.5% من المهام، ما يعني أن النموذج الجديد ينجز أكثر من 16 ضعفاً من الوظائف الاحترافية.
وحتى مقارنة بالقياسات الأحدث، تبدو القفزة كبيرة. ففي يوليو كان Fable 5، وهو نموذج أقدم من العائلة نفسها، في الصدارة بنحو 16%، بينما توقف سلفه المباشر Fable 5.1 عند أقل بقليل من 18%.
فارق واسع عن أقرب المنافسين
جاء Opus 5.5 من Anthropic في المركز الثاني بنسبة 21.25%، تلاه GPT 6 Astra من OpenAI بنسبة 20.83%، بينما حلّ Gemini Argon 4 من Google خامساً بنسبة 17.08%. أما النماذج الأقدم مثل GPT-5.2 وGemini 3 Pro فبقيت دون 3%. بهذا ينجز Fable 5.2 تقريباً ضعف ما تنجزه أفضل الأنظمة التالية في السوق.
أين تفوّق النموذج وأين تعثّر
بحسب Scale Labs، جاءت أكبر مكاسب النموذج في تحرير الصوت والموسيقى، والتصميم المعماري والداخلي، وصناعة النماذج ثلاثية الأبعاد، كما بات يتعامل مع مشاريع طويلة ومعقدة كانت النماذج المتصدرة سابقاً تفشل فيها. ونحو 50 من المهام التي نجح فيها لم يحلها أي وكيل ذكاء اصطناعي في الاختبار من قبل.
في المقابل، يقول الباحثون إن النموذج ما زال بالكاد يتعامل مع التصميم الصناعي للمنتجات والرسوم المتحركة. وعندما تفشل الوكلاء، فإنها تسلّم غالباً عملاً بمستوى هاوٍ أو نتائج ناقصة أو ملفات تالفة أو تصاميم متناقضة.
اختبار مبني على وظائف حقيقية لا أسئلة معزولة
على خلاف الاختبارات التقليدية التي تقيس مهارات منفصلة، يغطي المؤشر مهام عمل كاملة. وتضم بياناته 240 مشروعاً منجزاً من 358 مستقلاً موثقاً على منصة Upwork، تبلغ قيمتها مجتمعة نحو 144 ألف دولار.
- متوسط تكلفة المشروع الواحد 632.60 دولاراً.
- يستغرق المستقل البشري قرابة 29 ساعة في المتوسط لإنجازه.
- تتنوع المهام بين تحرير الفيديو وتصميم CAD وتطوير الألعاب وتحليل البيانات.
وتعمل الوكلاء داخل مساحة عمل افتراضية تضم برامج احترافية شائعة مثل Blender وGIMP وAudacity، إلى جانب أدوات ذكاء اصطناعي متخصصة لتوليد الصور والصوت والفيديو.
لماذا ما زال البشر هم الحكم
يراجع خبراء مدرَّبون كل نتيجة يدوياً، فيفتحون الملفات في البرامج الاحترافية المناسبة ويقارنونها مباشرة بعمل المستقل البشري. وقد فشلت محاولات CAIS لأتمتة هذه المراجعة بنموذج ذكاء اصطناعي آخر، لأن المراجعين الآليين بالكاد يستطيعون تشغيل هذه البرامج بأنفسهم، فينخدعون بأعمال تبدو مصقولة من الخارج لكنها معيبة تقنياً.


الرقم لافت، لكن قراءته الأدق أن الآلة باتت تتقن أجزاء متزايدة من العمل الإبداعي والتقني، فيما يبقى الحكم على الجودة، حتى الآن، مهارة بشرية خالصة. وربما تكون هذه المهارة تحديداً هي ما سيحدد قيمة المستقل في السنوات القادمة.
عبَّر عن رأيك
إحرص أن يكون تعليقك موضوعيّاً ومفيداً، حافظ على سُمعتكَ الرقميَّةواحترم الكاتب والأعضاء والقُرّاء.