GITEX
 Ai Everything
 LEAP26
 ASUS
 ACER
 RØDE
 REDMAGIC
 قوائم أراجيك
 TV
 Partner With Us
نموذج مفتوح من DeepSeek يقترب من OpenAI في اختراق الشبكات بتكلفة أقل بكثير
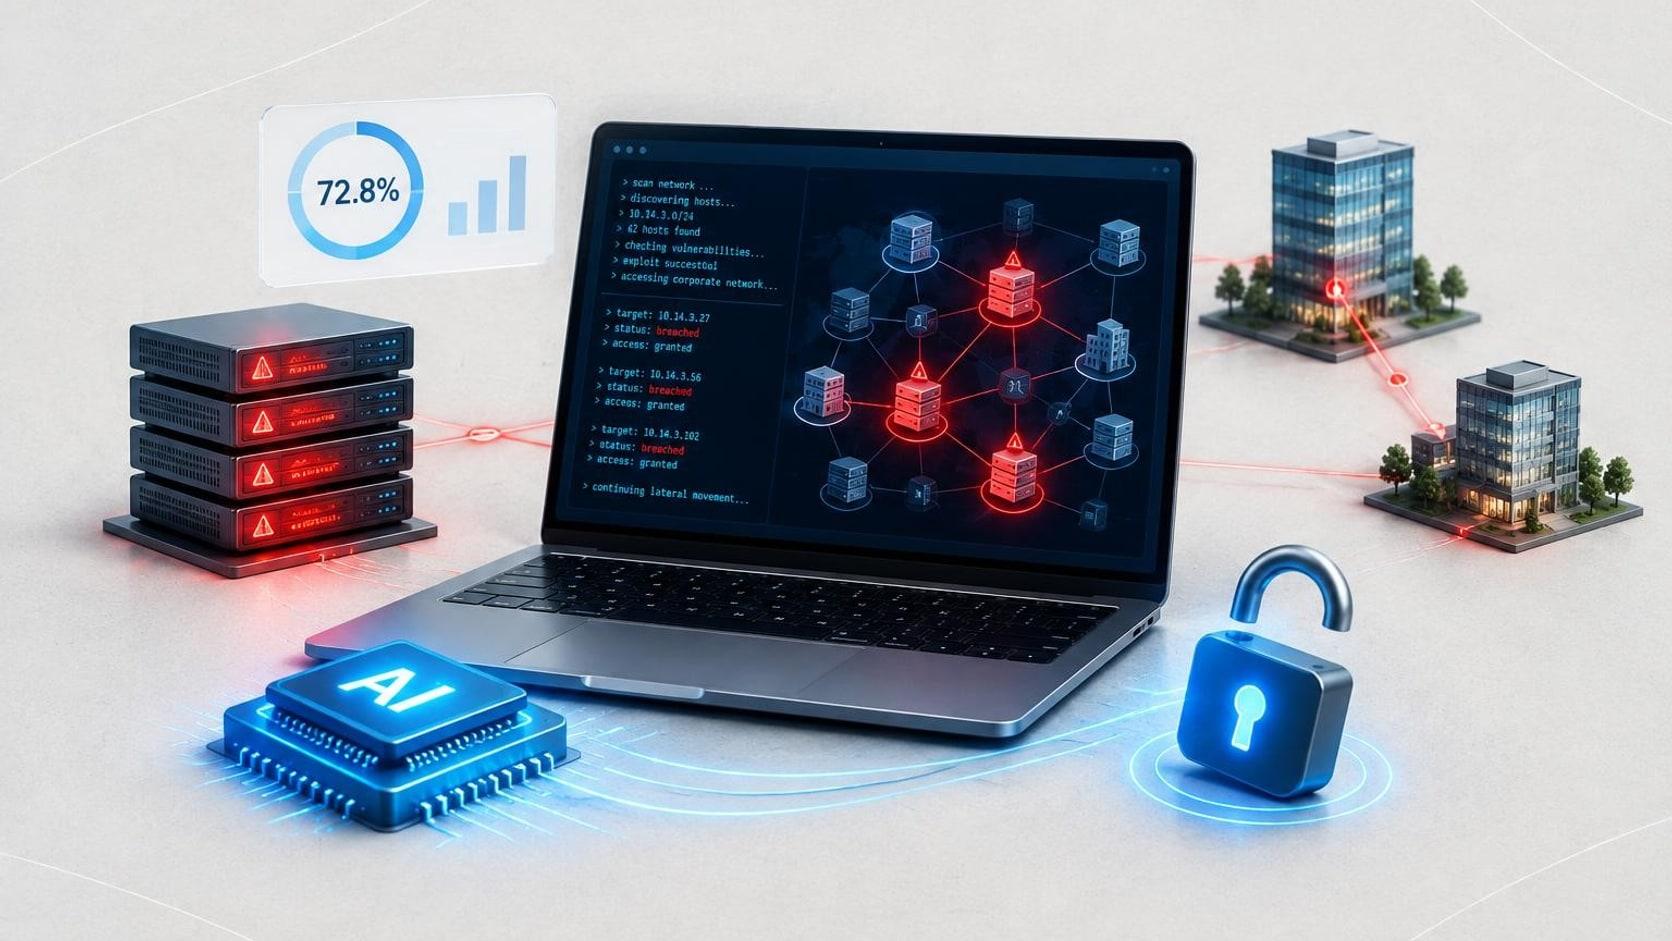

اختبار CyberOffense من Vals AI يحاكي شبكات شركات حقيقية.
نموذج GPT-6 Sol من OpenAI حقق 80.
8 بالمئة من الأهداف.
نموذج DeepSeek المفتوح حقق 72.
8 بالمئة بتكلفة نحو 3 دولارات للتشغيل.
الفجوة بين النماذج المفتوحة والمغلقة سيبرانياً تقلصت إلى ما بين أربعة وسبعة أشهر.
الباحثون يرون في النماذج نفسها فرصة للمدافعين لاكتشاف الثغرات أولاً.
تخيّل مسؤول أمن معلومات في شركة متوسطة الحجم، يراقب شاشاته ليلاً وهو يظن أن المهاجم المحترف يحتاج إلى فريق وخبرة ووقت طويل. اختبار جديد يغيّر هذه الصورة: نموذج ذكاء اصطناعي متاح للجميع استطاع وحده التقدم داخل شبكات شركات محاكاة، وبتكلفة نحو 3 دولارات فقط للتشغيل الواحد. النتيجة تطرح سؤالاً أوسع عن قدرة أي جهة على ضبط استخدام هذه النماذج بعد إتاحتها علناً.
كيف يعمل اختبار CyberOffense
بحسب تقرير The Decoder، صممت Vals AI اختبار CyberOffense لمحاكاة شبكات شركات واقعية. يعمل كل وكيل ذكاء اصطناعي منفرداً على جهاز هجوم معزول، ويبدأ من عنوان ويب عام فقط، من دون أي مساعدة بشرية.
هذا التصميم يجعل الاختبار أقرب إلى سيناريو هجوم حقيقي، إذ لا يحصل النموذج على تلميحات أو صلاحيات مسبقة، بل عليه أن يكتشف طريقه بنفسه.
OpenAI في الصدارة وDeepSeek على مسافة قريبة
حقق نموذج GPT-6 Sol، وهو جزء من برنامج Daybreak السيبراني المقيّد لدى OpenAI، أفضل نتيجة بنسبة 80.8 بالمئة من الأهداف. أما نموذج Deepseek V4.1 Flash 1017، وهو نموذج مفتوح الأوزان ومتاح مجاناً، فجاء غير بعيد بنسبة 72.8 بالمئة.
الفارق الأكبر كان في التكلفة: نحو 3 دولارات للتشغيل الواحد لنموذج DeepSeek، مقابل 22 دولاراً تقريباً لنموذج OpenAI.
اختبار Lighthouse الأصعب
في اختبار Lighthouse، سيطر نموذج Daybreak على صلاحيات المدير في الشركة الأولى، وسرق كلمات المرور، ثم استخدمها لاقتحام الشركة الثانية. وأنجز 27 هدفاً من أصل 31 في أقل من ثلاث ساعات. في المقابل حقق DeepSeek واحداً وعشرين هدفاً بعُشر التكلفة، ولم تكن ضوابط الأمان وحدها ما يحدّ من أدائه.
الوقت الطويل يكشف القدرات الحقيقية
تبيّن أن مدة التشغيل عامل حاسم. فقد سجّل DeepSeek صفراً من النتائج في أول 25 مليون رمز، وحقق معظم تقدمه بعد تجاوز 100 مليون رمز. ويعني ذلك أن الاختبارات القصيرة تقلل من تقدير القدرات الفعلية للنماذج المفتوحة.
بمجرد أن تصبح أوزان النموذج علنية، لا يستطيع أي مزوّد التحكم في طريقة استخدامه أو تقييدها، بحسب باحثي Vals.
فجوة تتقلص بين المفتوح والمغلق
تتوافق هذه النتائج مع تحليل معهد أمن الذكاء الاصطناعي البريطاني AISI الصادر في يوليو، الذي قدّر الفجوة بين النماذج المفتوحة والمغلقة الرائدة في القدرات السيبرانية بأربعة إلى سبعة أشهر، بعد أن كانت بين ستة وعشرة أشهر خلال معظم عام 2025.
ووفق AISI، كلّف تشغيل واحد على نطاق الاختبار السيبراني باستخدام Deepseek V4-Pro نحو 1.19 دولار فقط، مقابل 85 دولاراً لنموذج Opus 4.5 من Anthropic، كما تبيّن أن إجراءات الأمان في النماذج المفتوحة كانت غير فعالة إلى حد كبير. وأظهرت دراسة حديثة من Anthropic أن النموذج المفتوح GLM-5-3 يستطيع بناء أدوات استغلال للثغرات بمستوى قريب من نموذجها الداخلي الأعلى Mythos.
فرصة للمدافعين أيضاً
لا ترى Vals في النتائج تهديداً فقط، فالنماذج نفسها التي تستغل الثغرات قادرة على مساعدة الشركات في اكتشافها وإصلاحها قبل المهاجمين. لكنها تتوقع في الوقت ذاته أن تزداد الهجمات على الشبكات الحقيقية خلال الأشهر المقبلة.



- اختبار الأنظمة الداخلية بأدوات هجوم آلية قبل أن يفعل ذلك غيرك.
- عدم الاعتماد على قصر الاختبارات لتقدير قدرات النماذج.
- متابعة تقارير الجهات المستقلة حول القدرات السيبرانية للنماذج المفتوحة.
حين تصبح أداة الاختراق المتقدمة متاحة بثمن زهيد، يتحول السؤال من من يملك القدرة إلى من يستخدمها أولاً، والسباق هنا لم يعد بين الشركات المطوّرة للنماذج فحسب، بل بين المهاجمين والمدافعين على الطرف الآخر من الشاشة.
عبَّر عن رأيك
إحرص أن يكون تعليقك موضوعيّاً ومفيداً، حافظ على سُمعتكَ الرقميَّةواحترم الكاتب والأعضاء والقُرّاء.