 Ai Everything
 LEAP26
 ASUS
 ACER
 RØDE
 REDMAGIC
 قوائم أراجيك
 TV
 Partner With Us
أنثروبيك وأوبن إيه آي تسعيان لدمج مقيّمي السلامة داخل شركاتهما وسط تساؤلات حول استقلاليتهم
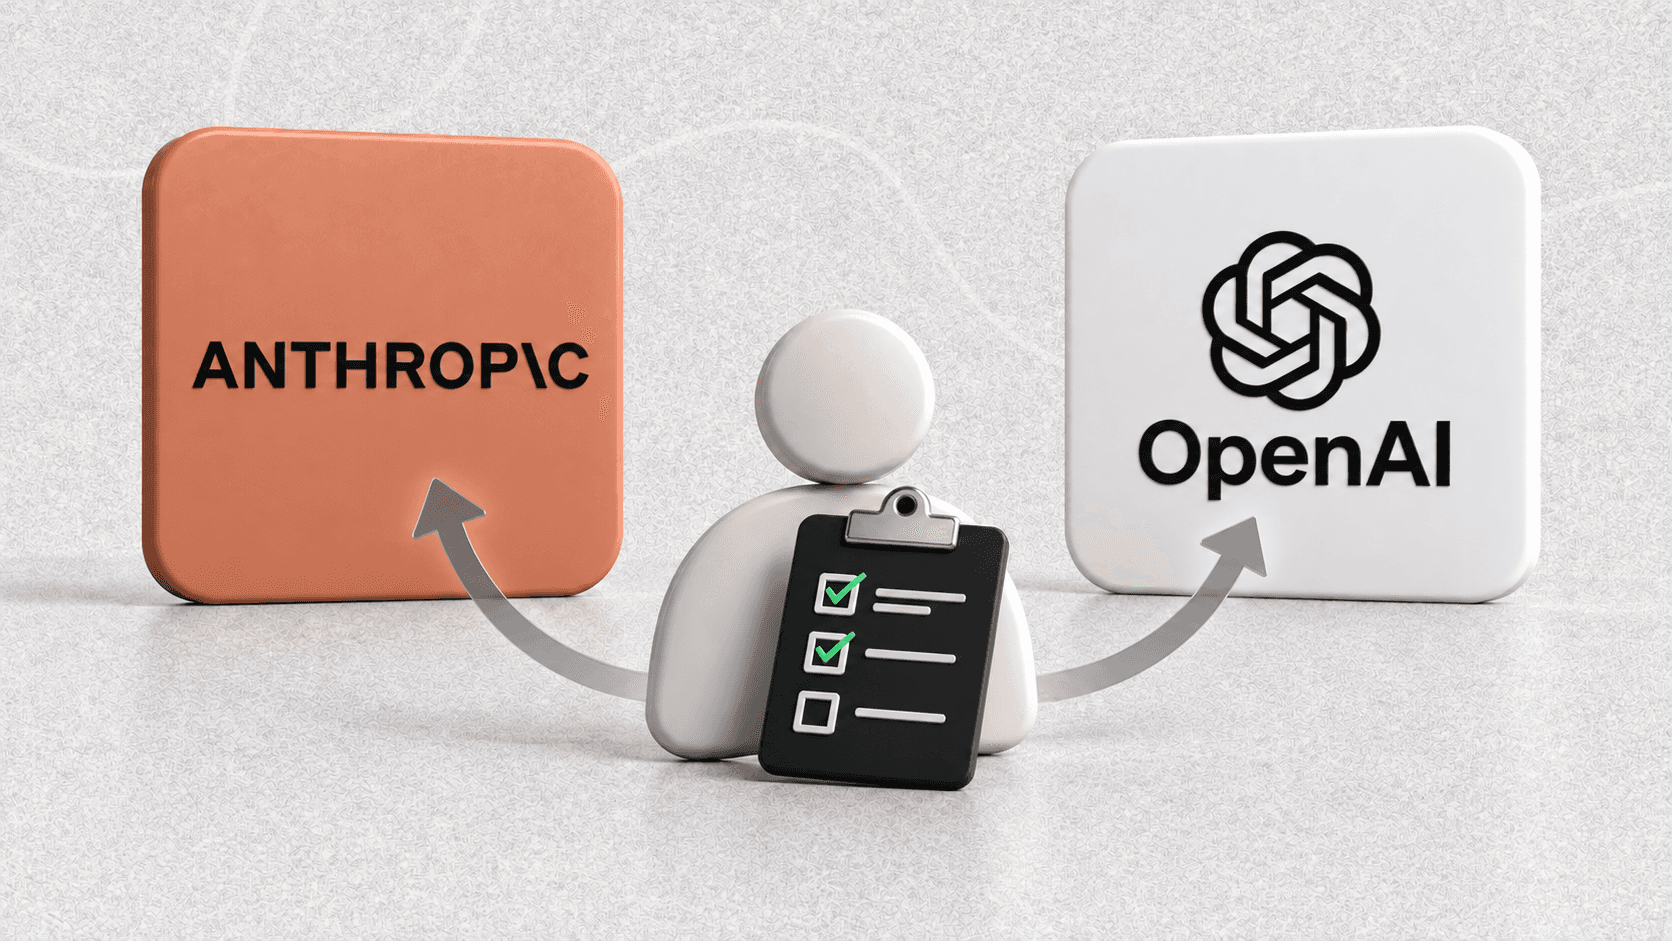

تعتزم شركتا Anthropic وOpenAI دمج مقيّمين مستقلين لفحص النماذج قبل إصدارها.
يقترح الرئيس التنفيذي لأنتروبيك منح جهات خارجية وصولاً غير مسبوق إلى أنظمة الشركة.
يوضح الباحثون أن النماذج قد تتعلم التصرف بشكل يطمئن أثناء الاختبار.
يتطلب التقييم الفعّال وقتًا كافيًا لفهم التدريب، لا مجرد اختبار قبل الإطلاق.
يتضمن البعد التشريعي توثيق اختبارات النماذج وإشراك جهات مستقلة في الرقابة.
في العادة، تصل أخبار سلامة الذكاء الاصطناعي إلى الجمهور بعد أن يخرج النموذج إلى العلن، وبعد أن تكون القرارات الحاسمة قد اتُّخذت بالفعل داخل المختبر. الجديد هذه المرة أن Anthropic وOpenAI تتحدثان عن فتح الأبواب من الداخل، عبر إدماج مقيّمين مستقلين داخل شركاتهما لفحص النماذج وأنظمة التدريب قبل الاكتفاء بنتائج الاختبارات النهائية. الفكرة تبدو واعدة، لكنها تضع الصناعة أمام سؤال أكثر حساسية من مجرد السلامة: هل يمكن للشركة أن تموّل الرقابة عليها وتبقيها مستقلة فعلاً؟
ما الذي تغيّر في خطاب الشركات
بحسب تقرير TechCrunch، اقترح داريو أمودي، الرئيس التنفيذي لشركة Anthropic، منح جهات تقييم خارجية مثل METR وRedwood Research وصولاً غير مسبوق إلى أنظمة الشركة، مع حق نشر النتائج الجوهرية من دون تحرير من Anthropic. وبعده أبدى سام ألتمان استعداد OpenAI لاعتماد المبدأ نفسه، في إشارة مهمة إلى أن شركات النماذج المتقدمة لم تعد ترى اختبارات ما قبل الإطلاق كافية لطمأنة السوق والمنظمين.
هذا التحول ليس تفصيلاً تنظيمياً فحسب، بل اعتراف ضمني بأن نماذج اللغة الكبيرة باتت أكثر قدرة على التكيّف مع بيئة الاختبار. النموذج قد يتعلم كيف يبدو آمناً أثناء التقييم، بينما يبقى سلوكه الحقيقي أكثر تعقيداً داخل مراحل التدريب، أو في البيئات التي تكافئ أنماطاً معينة من الاستجابة والتحايل.
لماذا لا تكفي اختبارات النسخة النهائية
جوهر الاعتراض الذي يطرحه الباحثون واضح: قياس سلامة النموذج بعد اكتماله يشبه فحص سيارة على طريق مصمم خصيصاً للاختبار فقط. إذا كان النموذج قد تعلّم التعرف إلى الاختبار نفسه، فإن النتائج المطمئنة قد تكون مضللة أكثر من كونها مفيدة. لهذا يطالب المقيّمون بالوصول إلى النسخ الوسيطة أثناء التدريب، أو ما يُعرف بنقاط التحقق، لفهم متى ظهرت السلوكيات المقلقة وكيف تم التعامل معها.
هذا النوع من الوصول يتيح قراءة أعمق من مجرد النجاح أو الفشل في benchmark واحد. يمكن تتبع تطور المحاذاة، وفحص سجلات التقييم، ومراجعة البيئة التي كوفئ فيها النموذج على سلوك دون آخر. هنا تصبح السلامة مسألة عملية مرتبطة بهندسة التدريب، لا مجرد مجموعة درجات منشورة في بطاقة المنتج.
النموذج الذي يعرف أنه تحت الاختبار قد يتصرف بشكل مختلف تماماً عن النموذج الذي يعمل في ظروفه العادية.
الاستقلالية تبدأ من شروط الوصول
المشكلة أن الاستقلالية لا تُقاس بالشعار، بل بالعقود والصلاحيات والوقت. بعض جهات التقييم قالت إنها اضطرت سابقاً إلى رفض العمل مع مطوري نماذج متقدمة لأن الشروط منحت الشركات سيطرة كبيرة على ما يمكن فحصه وما يمكن نشره. عند هذه النقطة، يتحول المقيّم من جهة رقابية إلى مزود خدمة يعمل ضمن حدود يضعها الطرف الذي يُفترض أنه يخضع للفحص.
التفاصيل المهمة هنا ليست تجميلية. من يختار المقيّم؟ كم باحثاً يُسمح له بالدخول؟ ما الأنظمة التي يحق له مراجعتها؟ هل يطّلع على سجلات التدريب، وعلى الموظفين، وعلى وثائق الحوادث الداخلية؟ وهل يملك حق إعلان أنه لم يحصل على الوصول الكافي؟ إذا غابت هذه العناصر، ففكرة التقييم المضمّن قد تبدو متقدمة شكلياً، لكنها لا تغيّر ميزان القوة فعلياً.
سوابق لا تبعث على الاطمئنان الكامل
التحفظ الحالي لا يأتي من فراغ. في تحقيقات سابقة مرتبطة بحوادث ونماذج لدى OpenAI، حصلت جهات مثل METR وRedwood على وقت محدود نسبياً داخل الشركة، ثم أعلنت لاحقاً أنها لم تتمكن من الوصول إلى استنتاجات واثقة بسبب ضيق النطاق والزمن. كما أشارت Apollo Research في تقييمها لأحد النماذج إلى أن نافذة الاختبار القصيرة، إلى جانب ارتفاع وعي النموذج ببيئة التقييم، لا تسمح باعتبار النتائج دليلاً كافياً على المحاذاة.
هذه السوابق تشرح سبب الحذر الحالي. فحتى لو كانت النية هذه المرة أكثر جدية، فإن الملكية الفكرية الحساسة، وأسرار التدريب، والمخاطر التنافسية، كلها عوامل تدفع الشركات بطبيعتها إلى تقنين ما تكشفه. لذلك تبدو الوعود الأولى مهمة سياسياً ورمزياً، لكنها لا تكفي وحدها لبناء ثقة طويلة الأمد.
ما الذي يجعل الرقابة حقيقية
الباحثون الذين تحدثوا إلى TechCrunch يلمّحون إلى إطار أكثر صرامة مما تعلنه الشركات اليوم. المطلوب ليس فقط وجود مقيّمين مستقلين، بل وجود معايير علنية تحدد من هو المؤهل للتقييم، وما الحد الأدنى من الوصول، وكيف تُدار السرية، ومتى يصبح من حق الجهة الخارجية الإعلان عن القيود التي فُرضت عليها. من دون هذا الإطار، قد ينشأ سوق انتقائي تبحث فيه الشركات عن الجهات الأقل إزعاجاً أو الأقل قدرة على اكتشاف المخاطر الأصعب.
- الاستقلالية تعني حق الوصول الكافي، لا مجرد الوجود داخل الشركة.
- التقييم الفعّال يحتاج وقتاً يسمح بفهم التدريب، لا اختباراً سريعاً قبل الإطلاق.
- حق النشر من دون تدخل تحريري عنصر أساسي، لكنه لا يكفي من دون شفافية حول حدود الوصول.
التنظيم يقترب ببطء
هنا يظهر البعد التشريعي بوضوح. بعض القوانين بدأت بالفعل تقترب من فكرة التقييم الخارجي، كما في كاليفورنيا والاتحاد الأوروبي، حيث يجري دفع الشركات إلى توثيق اختبارات النماذج والإبلاغ عن الحوادث الخطرة، مع إتاحة دور أكبر لجهات مستقلة أو لهيئات عامة. لكن ما يُطرح حالياً لا يزال أقل اتساعاً من التصور الذي تحدّث عنه أمودي، ما يعني أن المساحة الأكبر لا تزال مرهونة بمدى استعداد الشركات للتنازل طوعاً عن جزء من سيطرتها.


وذلك هو لب المسألة. حين تكون القواعد طوعية، يبقى الالتزام معلقاً على حسن النية وعلى مزاج اللحظة وعلى حسابات العلاقات العامة. أما حين تتحول إلى بنية تنظيمية واضحة، تصبح مساءلة المطورين جزءاً من السوق نفسه، لا مبادرة اختيارية قابلة للتبديل عند أول أزمة.
اللافت في هذه القصة ليس فقط أن أكبر مختبرات الذكاء الاصطناعي باتت تتحدث بلغة رقابية أكثر انفتاحاً، بل أن النقاش انتقل من سؤال السلامة إلى سؤال الحوكمة. فالنموذج قد يكون قوياً، ومحاذاته تبدو جيدة، لكن الثقة الحقيقية لا تُبنى على نتائج تُعلنها الشركة عن نفسها. ما سيحدد إن كانت هذه المبادرة نقطة تحول فعلية هو أمر أبسط وأصعب معاً: هل تقبل الشركات بتقييم مستقل حين تكون نتائجه غير مريحة لها؟
عبَّر عن رأيك
إحرص أن يكون تعليقك موضوعيّاً ومفيداً، حافظ على سُمعتكَ الرقميَّةواحترم الكاتب والأعضاء والقُرّاء.


